BlenderのCyclesでレンダリングが遅いときは、GPUで描けているか、サンプル数が多すぎないか、GPUのメモリが足りているかの順に確かめます。
練習シーンで設定を1つずつ変えて測ると、時間を大きく変えたのはサンプル数(ノイズしきい値)、デノイズ、CPUのスレッド数でした。
既定の設定のままでは145.5秒かかり、ノイズしきい値を0.01から0.1にするだけで約31秒になりました。
症状ごとに、先に見るところを表にまとめます。
| 症状 | 先に見るところ |
|---|---|
| GPUがあるのにCPUで描いたときと時間が変わらない | GPUで描く設定の2か所 |
| 既定の設定のまま1枚に何分もかかる | ノイズしきい値と最大サンプル数 |
| GPUにすると急に遅くなる、GPUでは描けない | GPUのメモリ |
| 描き始めるまでが長い、アニメーションの毎フレームが遅い | 永続データと簡略化 |
| どの設定が効いているのかわからない | 条件を1つずつ変えて測る |
| レンダリング中にBlenderが固まる | 表示用とレンダー用のGPU |
ノイズを減らす設定はBlenderのレンダリングノイズを減らす方法にまとめ、この記事では時間を短くする設定を扱います。
この記事は、Blender 5.2 LTSの公式マニュアル(2026年10月18日に確認)の記載に基づき、2026年11月19日に最新のBlender 5.3のマニュアル(日本語版)で同じ記載を確かめ直しました。
画面と時間は、2026年10月20日にBlender 5.2.1 LTS(Windows 11、CPUはRyzen 5 7530U)で、練習用に作ったシーンを使って確かめました。
設定は日本語表示の画面で変え、時間はレンダーの窓の表示と、コマンドラインで起動したBlenderでの計測で測りました。
この機械にはCyclesで使えるGPUが無いため、GPUで描いたときの速さと、GPUのメモリ不足の症状は確かめていません。
画面の項目名は、Blender 5.2.1の日本語表示の画面に合わせ、一部に英語の表示名を添えています。
GPUで描く設定になっているか確かめる
公式マニュアルでは、GPUレンダリングを使う手順は次の3つです。
- プリファレンスの「システム」にある「Cyclesレンダーデバイス」で、CUDA・OptiX・HIP・oneAPI・Metalのどれかを選ぶ
- 選んだ方式で使える機器にチェックを入れる
- シーンごとに、レンダープロパティの「デバイス」を「GPU演算」(GPU Compute)にする
Cyclesレンダーデバイスが「なし」のままだと、CPUで描かれます。
この機械(AMDの内蔵グラフィックス)では、PythonでCyclesの機器の一覧を読むと、CUDA・OptiX・HIP・oneAPIのどれも0台で、Cyclesレンダーデバイスは「なし」でした。
この状態でレンダープロパティのデバイスを「GPU演算」にすると、項目が灰色の表示になりました。
そのまま描くとエラーは出ず、時間は10.10秒で、デバイスを「CPU」にしたとき(10.14秒)と変わりませんでした。
「GPU演算」が灰色なら、GPUでは描かれていないと考えて、プリファレンスの側を確かめます。
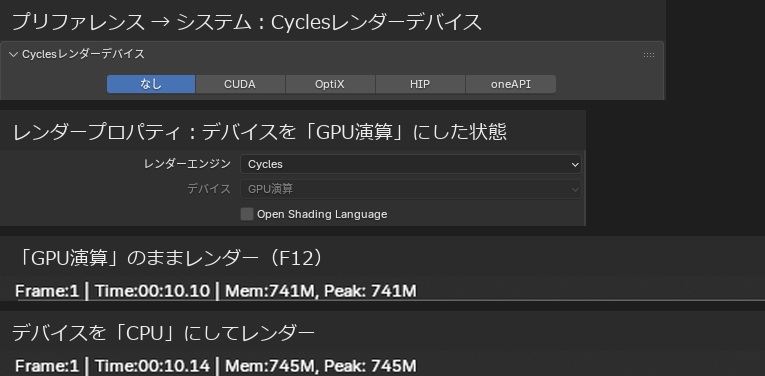
プリファレンスを設定しても、シーンのデバイスがCPUのままならCyclesの描画計算はCPUで行うため、2か所とも確かめます。
デノイズとコンポジターには別のデバイス設定があり、これらのGPU利用はCycles本体の設定と区別してください。
デバイスの設定はシーンごとなので、別のファイルを開いたときにも確かめておくと安心です。
GPUの種類ごとの方式と条件
| GPU | 選ぶ方式 | 公式マニュアルにある条件 |
|---|---|---|
| NVIDIA | OptiXかCUDA | どちらも演算能力5.0以上。OptiXはドライバー575以上で、RTXのレイトレーシング用の回路を使う |
| AMD | HIP | RDNA1以降(Radeon RX 5000シリーズ以降)。Windowsはドライバー24.9.1以上。RX 6000以降はプリファレンスでハードウェアレイトレーシングを有効にできる |
| Intel | oneAPI | Arc A・Bシリーズ。レイトレーシングとデノイズのハードウェア処理に対応 |
| Apple | Metal | Appleシリコン搭載のMac。すべての機能を使うにはmacOS 13以降 |
公式マニュアルでは、パソコンのメーカーが配っているドライバーは古かったり不完全だったりすることがあるため、GPUのメーカーのサイトから公式ドライバーを入れるようにすすめています。
Cyclesレンダーデバイスに自分のGPUが出てこない場合は、まずドライバーを確かめます。
どの方式やGPUが速いかは、ハードウェアとシーンによって変わるため、公式マニュアルではBlender Open Dataの結果を見るように案内されています。
GPUのメモリが足りていないか
GPUが使えるのは、基本的にGPUに載っているメモリだけで、パソコン本体のメモリよりかなり少ないことが多いです。
公式マニュアルでは、CUDA・OptiX・HIP・Metalでは、GPUのメモリがいっぱいになると本体のメモリを自動で使おうとし、その分だけ遅くなると書かれています。
それでもCPUで描くより速いことが多いとされています。
CPUでは描けるのにGPUでは描けないシーンは、多くの場合GPUのメモリ不足が原因です。
メモリを減らす方法として、公式マニュアルでは画像テクスチャの解像度を下げることが挙げられています。
次の表は公式の目安で、シーン全体の必要メモリではありません。
ポリゴンやレンダーパスなどにもメモリを使うため、画像の数値だけで必要なGPUメモリを判断しないでください。
| テクスチャの大きさ | 使うメモリ |
|---|---|
| 8k | 256MB |
| 4k | 64MB |
| 2k | 16MB |
| 1k | 4MB |
GPUを2枚挿しても、ふつうはそれぞれのGPUが自分のメモリしか使えないため、使えるメモリは増えません。
重い工程を切り分ける
遅さの原因を探すときは、条件を1つずつ変えて、どこで時間が延びるかを比べます。
| 試すこと | 時間が大きく変わったら |
|---|---|
| デバイスをCPUとGPU演算で切り替える | GPUの設定やメモリが原因の候補 |
| 最大サンプル数を下げる | 光の計算の量が原因。ノイズしきい値とデノイズで必要なサンプル数を減らす |
| 「簡略化」で最大細分化数とテクスチャサイズ上限を下げる | 細分化のしすぎや大きなテクスチャが原因の候補 |
| ライトパスの最大バウンス数を下げる | 跳ね返りの回数が原因の候補 |
比べるときは、解像度やサンプル数などのほかの条件をそろえ、1か所だけを変えます。
練習シーンで測った時間(CPU)
1体あたり約50万面に細分化したサル5体、金属とガラスの球、8192ピクセルの画像を貼った床を、1280×720で描いて測りました。
基準は、ノイズしきい値を外した32サンプル・デノイズなし・12スレッドです。
| 変えたこと | 時間 | 基準と比べて |
|---|---|---|
| なし(基準) | 11.5〜12.6秒 | - |
| デバイスを「GPU演算」(使える機器なし) | 12.1〜13.7秒 | 変わらない |
| 簡略化:最大細分化数を2 | 10.2〜11.1秒 | 1秒ほど短い |
| 簡略化:テクスチャサイズ上限を1024 | 11.7〜12.7秒 | 変わらない |
| タイルサイズを512 | 12.2〜12.8秒 | 変わらない |
| 最大バウンス数を4 | 11.9秒 | ほぼ変わらない |
| スレッドを固定の4 | 21.3〜22.1秒 | 約1.8倍 |
| 32サンプルにデノイズを足す | 18.2〜18.6秒 | 6秒ほど長い |
| 128サンプル・デノイズなし | 39.6秒 | 約3.3倍 |
| ノイズしきい値0.1・最大4096・デノイズ | 30.9〜31.2秒 | 約2.6倍 |
| 既定(ノイズしきい値0.01・最大4096・デノイズ) | 145.5秒 | 約12倍 |
時間は、コマンドラインで起動したBlenderで、レンダリングの命令の前後を測りました。
同じ条件でも1〜2秒ほどばらつくため、1秒前後の差は誤差に近いと見てください。
このシーンで時間を大きく変えたのは、サンプル数、デノイズ、スレッド数でした。
簡略化やタイルサイズは、時間よりもメモリに効きました(後の「簡略化」で数字を示します)。
時間を短くする設定
サンプル数を減らす
最大サンプル数は、1画素あたりに計算するパス数の上限です。
ノイズしきい値によって先に終了している場合は、上限だけを変えても時間や画質が変わらないことがあります。
「ノイズしきい値」を使うと、十分きれいになった画素はサンプリングを早めに打ち切ります。
デノイズを組み合わせると、少ないサンプル数でもノイズの少ない絵にできます。
練習シーンでは、既定の設定(ノイズしきい値0.01・最大4096・デノイズ)で145.5秒かかり、ノイズしきい値を0.1にすると31秒ほどになりました。
サンプル数の目安とデノイズの設定は、Blenderのレンダリングノイズを減らす方法で、同じように描き比べた結果つきで解説しています。
時間制限で1回の上限を決める
レンダープロパティの「サンプリング」にある「時間制限」に秒数を入れると、最大サンプル数に届いていなくても、その時間でレンダリングを止めます。
公式マニュアルでは、描き始める前の準備にかかる時間は含まれないと書かれています。
0にすると制限しない設定で、Blender 5.2.1の既定値は0でした。
1枚にかけられる時間が決まっているときに使えますが、止まった時点のノイズが残るため、デノイズと組み合わせて仕上がりを確かめます。
時間制限の効き方は、練習シーンでは測っていません。
パフォーマンスの設定
レンダープロパティの「パフォーマンス」には、速さとメモリのどちらを優先するかのプリセットがあります。
| 項目 | 公式マニュアルの説明 |
|---|---|
| プリセット:デフォルト | メモリの節約と速さのバランスをとる |
| プリセット:高速レンダリング | メモリを多く使う代わりに速く描く |
| プリセット:メモリ節約 | 遅くなる代わりにメモリを節約する |
| スレッドモード | CPUで描くときに使うコア数。自動検知は論理プロセッサーの数に合わせる。描きながらパソコンを使うなら固定で少なくする |
| タイルサイズ | 既定の2048ピクセルで多くのシーンは釣り合いがとれる。メモリが足りないときは1024や512に下げると、少し遅くなる代わりにメモリが減る |
| 永続データ | 描いた後もデータをメモリに残し、描き直しやアニメーションを速くする。その分、ほかの作業中のメモリが増える |
| 空間分離を使用 | 大小のポリゴンが混ざったシーンで描く速さが上がる。描く前の準備は長くなり、メモリも少し増える |
Blender 5.2.1では、プリセットのボタンは「パフォーマンス」の見出しの右にあり、一覧はデフォルト・高速レンダリング・メモリ節約の3つでした。
当ててみると、高速レンダリングは「空間分離を使用」と「永続データ」をオンにし、メモリ節約はタイルサイズを512にして「コンパクトBVHを使用」をオンにしました。
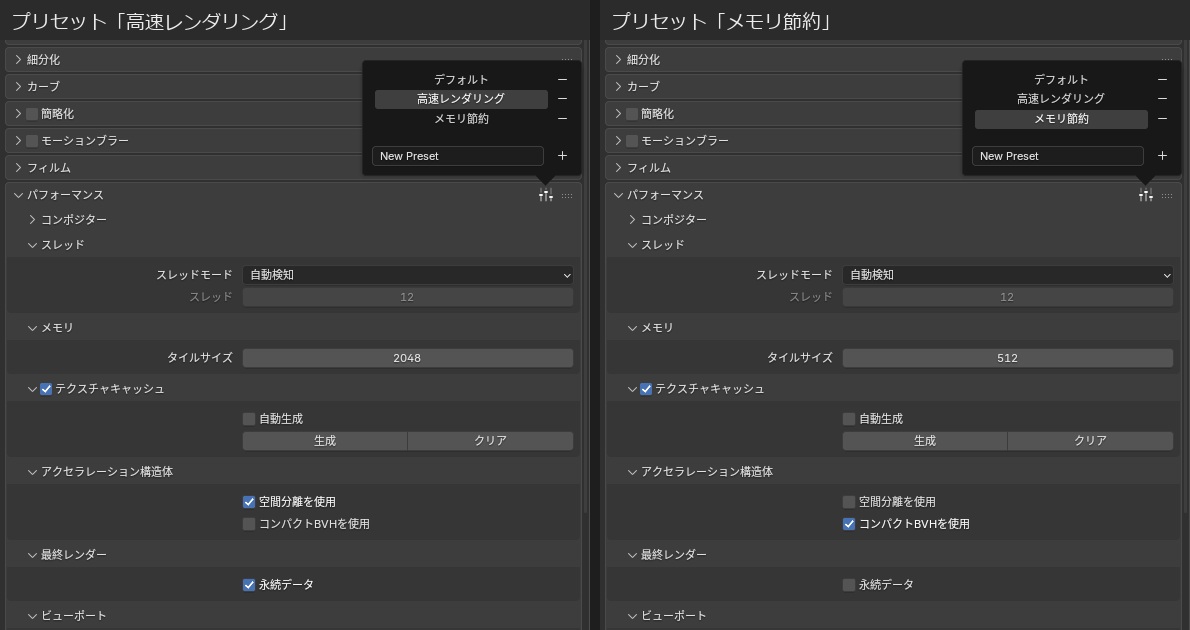
画面には、上の表に無い「テクスチャキャッシュ」と「コンパクトBVHを使用」の項目もありました。
5.2の公式説明では、テクスチャキャッシュは画像をタイル化した.txファイルを使って必要部分を読み込み、メモリと起動時間を抑える代わりにディスク容量を使います。
コンパクトBVHは加速構造のメモリを抑える代わりにレンダーが遅くなる場合があります。
この2項目の効果は練習シーンでは計測していません。
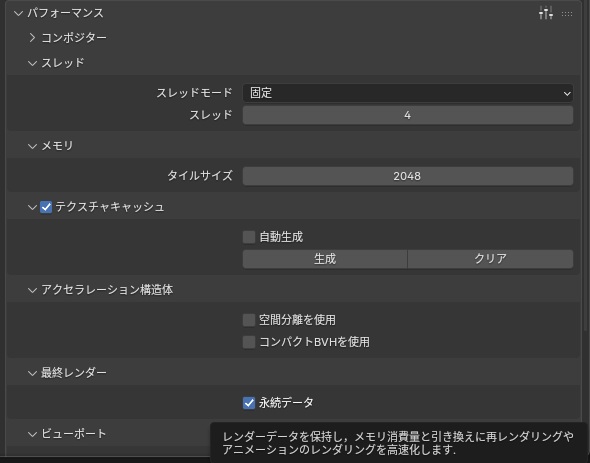
スレッドモードを「固定」にしてスレッドを4にすると、自動検知(この機械では12)と比べて時間が約1.8倍になりました。
タイルサイズを512にしても、1280×720の画像ではピークのメモリが745MBから732MBに減っただけで、時間は変わりませんでした。
アニメーションを描くときは、永続データをオンにすると、フレームごとの準備を減らせます。
練習シーンで3フレームを続けて描くと、永続データがオフでは2・3フレーム目も1枚11〜12秒でしたが、オンでは9.2〜9.8秒になりました。
縮んだ約2秒は、1フレーム目で描き始めるまでにかかった準備の時間とほぼ同じでした。
簡略化
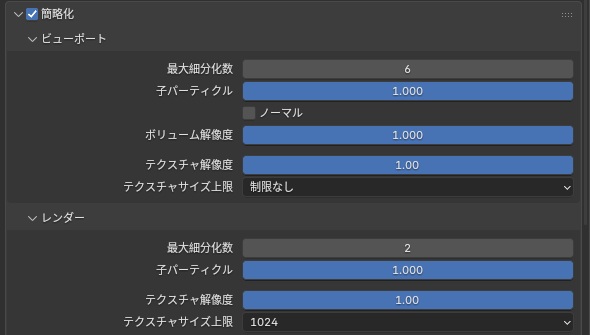
レンダープロパティの「簡略化」では、シーンの重さを一括で下げられます。
- 最大細分化数:サブディビジョンサーフェスモディファイアーの細分化の回数の上限
- 子パーティクル:子の毛やパーティクルを一部だけにする
- テクスチャサイズ上限:決めた大きさより大きなテクスチャを自動で縮める
Blender 5.2.1の画面には、このほかに「テクスチャ解像度」の項目もありました。
公式説明では、画像テクスチャを縮小してメモリ使用量を減らす設定です。
ビューポートとレンダーで別々に設定できるため、作業中だけ軽くすることもできます。
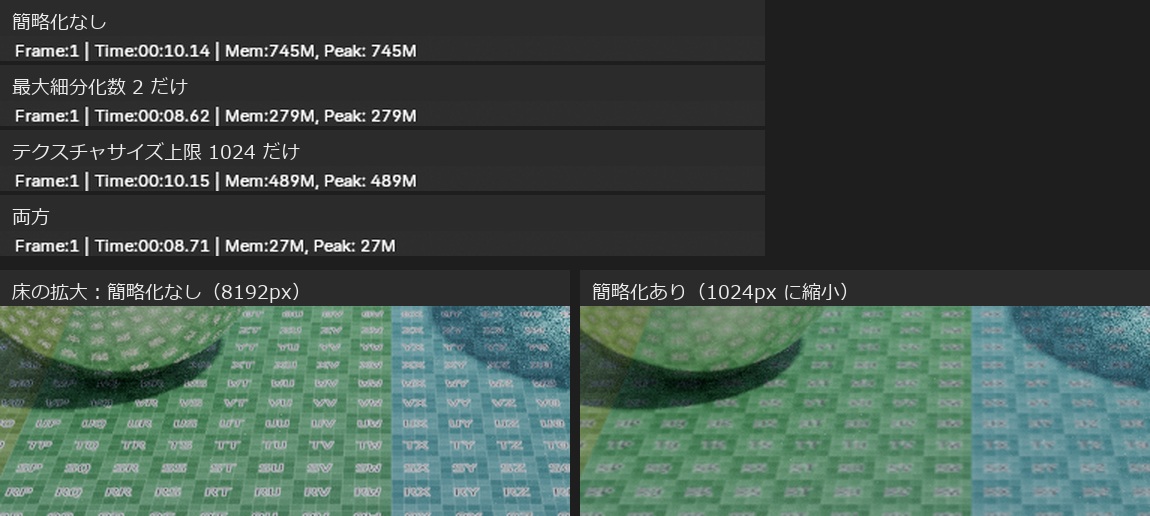
練習シーンで、レンダー側の値を変えて描いたときの、レンダーの窓の表示です。
| 簡略化の設定 | 時間 | ピークのメモリ |
|---|---|---|
| なし | 10.14秒 | 745MB |
| 最大細分化数を2だけ | 8.62秒 | 279MB |
| テクスチャサイズ上限を1024だけ | 10.15秒 | 489MB |
| 両方 | 8.71秒 | 27MB |
表のメモリ値は、当時のレンダー画面に表示されたPeakの記録です。
細分化を下げると表示値が約470MB、テクスチャを縮めると約260MB減り、両方では27MBでした。
PC全体のRAM使用量やGPUのVRAM使用量を測った値ではないため、「27MBのメモリでこのシーンを扱える」という意味ではありません。
テクスチャで減った量は、8192ピクセルの画像についての前の表の256MBとほぼ同じでした。
一方で、テクスチャを縮めると床の文字は読めないほどぼやけました。
仕上げの絵では細部も粗くなるため、GPUのメモリが足りないときの切り分けや、作業中の確認に使うのが向いています。
カメラに映らない物を外す(カリング)
画面の外にも物が多いシーンでは、「簡略化」の「カリング」で、カメラに映らない物をレンダリングの計算から外せます。
使うには、「簡略化」の「カメラカリング」と、外したい物のオブジェクトプロパティ→「可視性」→「カリング」にある「カメラでカリング」の両方をオンにします。
「距離カリング」と「距離でカリング」を使うと、カメラから遠い物を外せます。
公式マニュアルでは、2つを組み合わせると、画面の外でも近くにあって反射に映る物を残せると説明されています。
カメラの外の物を外すと、反射や影から消えることがあるため、仕上げの前に見比べます。
練習シーンは全部の物がカメラに映る配置のため、カリングは試していません。
ライトパスのバウンス数と高速 GI 近似
レンダープロパティの「ライトパス」にある「最大バウンス数」は、光が跳ね返る回数の上限です。
公式マニュアルでは、品質を優先するなら大きくし、実際には速さのために小さくしてもよいとされています。
練習シーンでは、合計を4にしても11.9秒で、基準とほぼ変わりませんでした。
跳ね返りの多い室内のシーンでは結果が変わることがあるため、同じ条件で測ってから決めます。
「高速 GI 近似」をオンにすると、決めた回数より後の拡散光の跳ね返りを、背景の色をつけたアンビエントオクルージョン(AO)で置き換えます。
公式マニュアルでは、完全な間接光の計算の代わりに使う速い方法で、ビューポートや品質を下げてよい最終レンダーに向くと説明されています。
最終レンダーで何回跳ね返った後に置き換えるかは、「レンダーバウンス数」で決めます。
高速 GI 近似は練習シーンでは測っていないため、時間と明るさの変わり方は自分のシーンで比べてください。
レンダリング中にBlenderが固まるとき
公式マニュアルでは、古い世代のGPUは、レンダリングと画面の表示を同時にこなせないため、レンダリング中にBlenderが反応しなくなることがあると説明されています。
新しいGPUでも、重いシーンでは同じことが起きることがあります。
Windowsでは、表示とレンダリングを同じGPUで行うと、GPUが計算に使える時間に上限があり、重いシーンで表示用のドライバーとの接続が切れることがあります。
公式マニュアルでは、パフォーマンスのタイルサイズを下げると和らぐことがあるとしたうえで、根本的には表示用とレンダリング用でGPUを分けることが挙げられています。
まとめ
- GPUで描くには、プリファレンスのCyclesレンダーデバイスと、レンダーのデバイス「GPU演算」の2か所を設定する
- GPUが選べないときは、GPUのメーカーの公式ドライバーを入れる
- GPUのメモリが足りないと遅くなる。テクスチャの解像度や簡略化で減らす
- サンプル数は、ノイズしきい値とデノイズで必要な分だけにする
- アニメーションは永続データで準備の時間を減らす
CyclesとEEVEEのどちらで描くかも時間に大きく関わるため、BlenderのCyclesとEEVEEの違いもあわせてご覧ください。
GPUのメモリを含めたパソコンの選び方は、Blender用PCの選び方で解説しています。
参考:Blender 5.2 LTSマニュアル(GPU Rendering、Performance、Simplify、Render Settings、Preferences: System)。
2026年10月26日に掲載の公式5資料と、2026年10月20日の保存済み測定記録を再確認しました。
2026年11月19日に、Blender 5.3のマニュアル(日本語版)のSampling、Light Paths、Simplify、Object、GPU Rendering、Performanceを確かめ、時間制限・カリング・高速 GI 近似の説明を足しました。
今回、実機での再測定や画像の再撮影は行っていません。
ほかの症状はBlender・Mayaのエラー一覧で、症状別に先に確かめることをまとめています。